GeekProxy в Scrapy
В settings.py у Scrapy нет поля для прокси, и в первый день это сбивает с толку. Есть middleware, которая читает URL прокси из каждого запроса, и обычные переменные окружения. В гайде оба пути, судьба вашего пароля внутри middleware, SOCKS5 через httpx-обработчик и sticky-сессии на одном шлюзе.
Что нужно: активный план GeekProxy и данные прокси из кабинета. Первый краул через прокси занимает минут пять.
Получить прокси1 Перед началом
Вся поддержка прокси в Scrapy живёт в одной downloader middleware, HttpProxyMiddleware. Она включена по умолчанию с порядком 750 в DOWNLOADER_MIDDLEWARES_BASE, ставить ничего не надо. Её работа, по документации: выставить HTTP-прокси запросу, прочитав meta-значение proxy. Управляют ею две настройки: HTTPPROXY_ENABLED (по умолчанию True) и HTTPPROXY_AUTH_ENCODING (по умолчанию "latin-1").
Это всё. На весь проект прокси задаётся переменными окружения, на запрос через meta['proxy'], а соединить одно с другим может middleware на десять строк.
- Формат URL прокси:
scheme://[user:pass@]host:port. Строки видаhost:port:user:passScrapy не разбирает - Нормальная схема
http://. Проксиhttps://работает только с целямиhttp://, а с версии 2.16.0 стандартный обработчик бросает исключение, когда и цель, и проксиhttps://. Порты GeekProxy обычные HTTP-прокси, так что берёмhttp:// - SOCKS5 требует httpx-обработчик. Вердикт в разделе 5
- Через прокси идут только загрузки паука. Экспорт фидов, Telnet-консоль и Scrapyd не затронуты, если сами не читают те же переменные
Что понадобится
- Активный план GeekProxy (резидентские, ISP или датацентр)
- Данные прокси из кабинета: хост, порт, логин, пароль
- Python 3 с установленным Scrapy. Для httpx-обработчика нужен Scrapy 2.17 или новее
- Поле Откуда взять
- Протокол HTTP (SOCKS5 только через httpx-обработчик)
- Хост IP или имя шлюза из кабинета
- Порт из кабинета
- Логин из кабинета
- Пароль из кабинета
2 Где взять данные прокси
- Войдите в кабинет GeekProxy
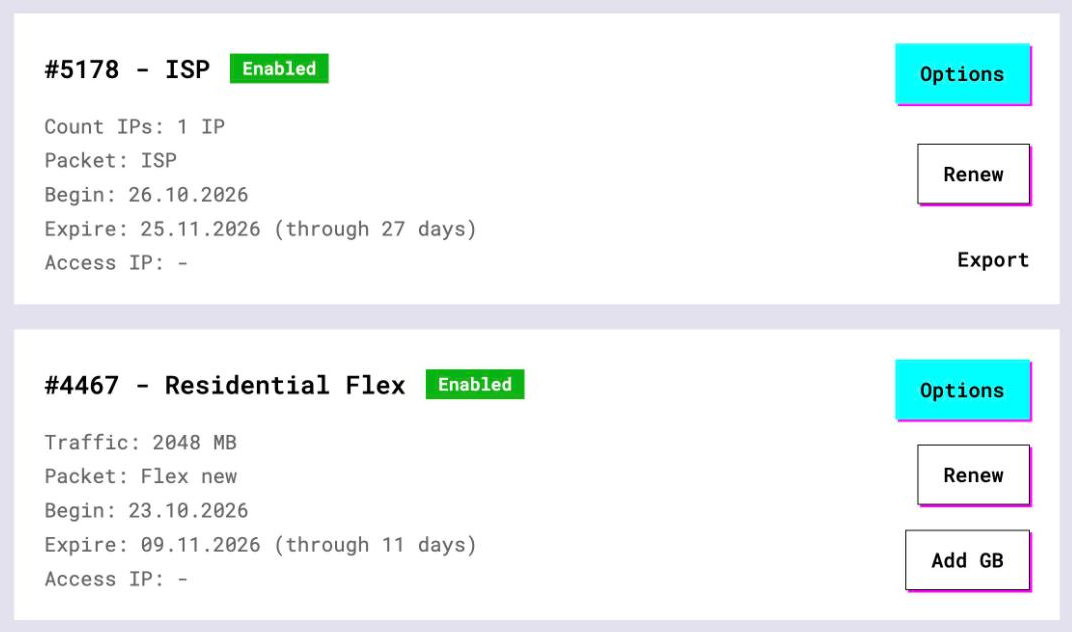
- Откройте план. У планов с оплатой за IP (датацентр, ISP) список адресов, порты, логин и пароль лежат прямо на карточке, а кнопка Export отдаёт весь список текстом
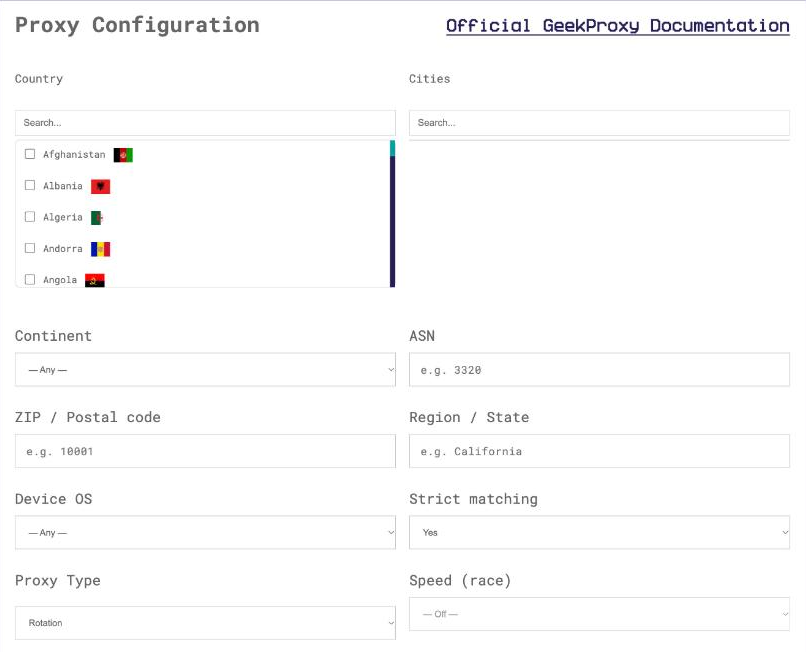
- У резидентских и мобильных планов нажмите Options. Панель Proxy Configuration соберёт строку логина с вашей страной, городом и настройками сессии. Готовую строку копируйте из Proxy List
Краулеру настройки сессии важнее страны. На Residential Turbo в логине живут session_id и session_time (от 1 до 1440 минут), на Residential Flex session_time до 120 минут и фильтр выхода вроде -os-windows.
3 Весь проект: переменные окружения
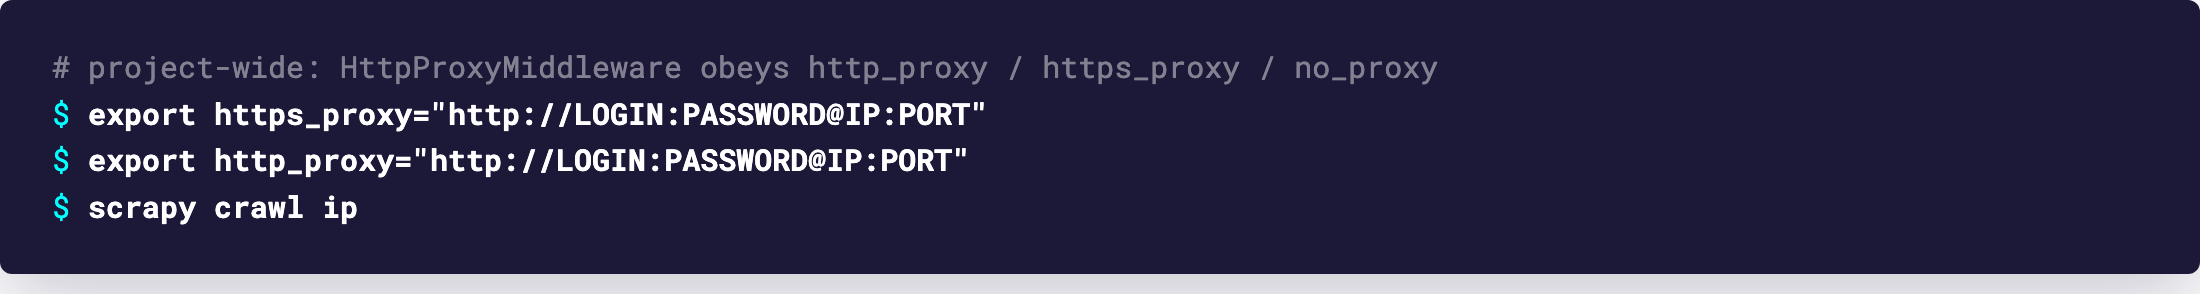
Как и urllib.request из стандартной библиотеки, middleware слушается http_proxy, https_proxy и no_proxy. Экспортируйте их в той оболочке, где запускаете краул, и каждый запрос каждого паука пойдёт через прокси. Логин и пароль внутри переменной разбирает та же функция, что и meta['proxy'], так что форма URL та же.
export https_proxy="http://LOGIN:PASSWORD@IP:PORT"
export http_proxy="http://LOGIN:PASSWORD@IP:PORT"
scrapy crawl ip
Задавайте обе. Переменная выбирается по схеме целевого URL, а краул, начавшийся на https://, вполне может уйти редиректом на http://. no_proxy выводит хост из-под прокси, это полезно, когда паук заодно ходит в ваш собственный API.
Переменные окружения это единственный общепроектный переключатель, который есть в Scrapy. Хотите выбирать прокси в коде? Маленькая downloader middleware, которая заполняет request.meta['proxy'] раньше порядка 750, решает вопрос. Пример в разделе 4.
4 На запрос: meta-ключ proxy
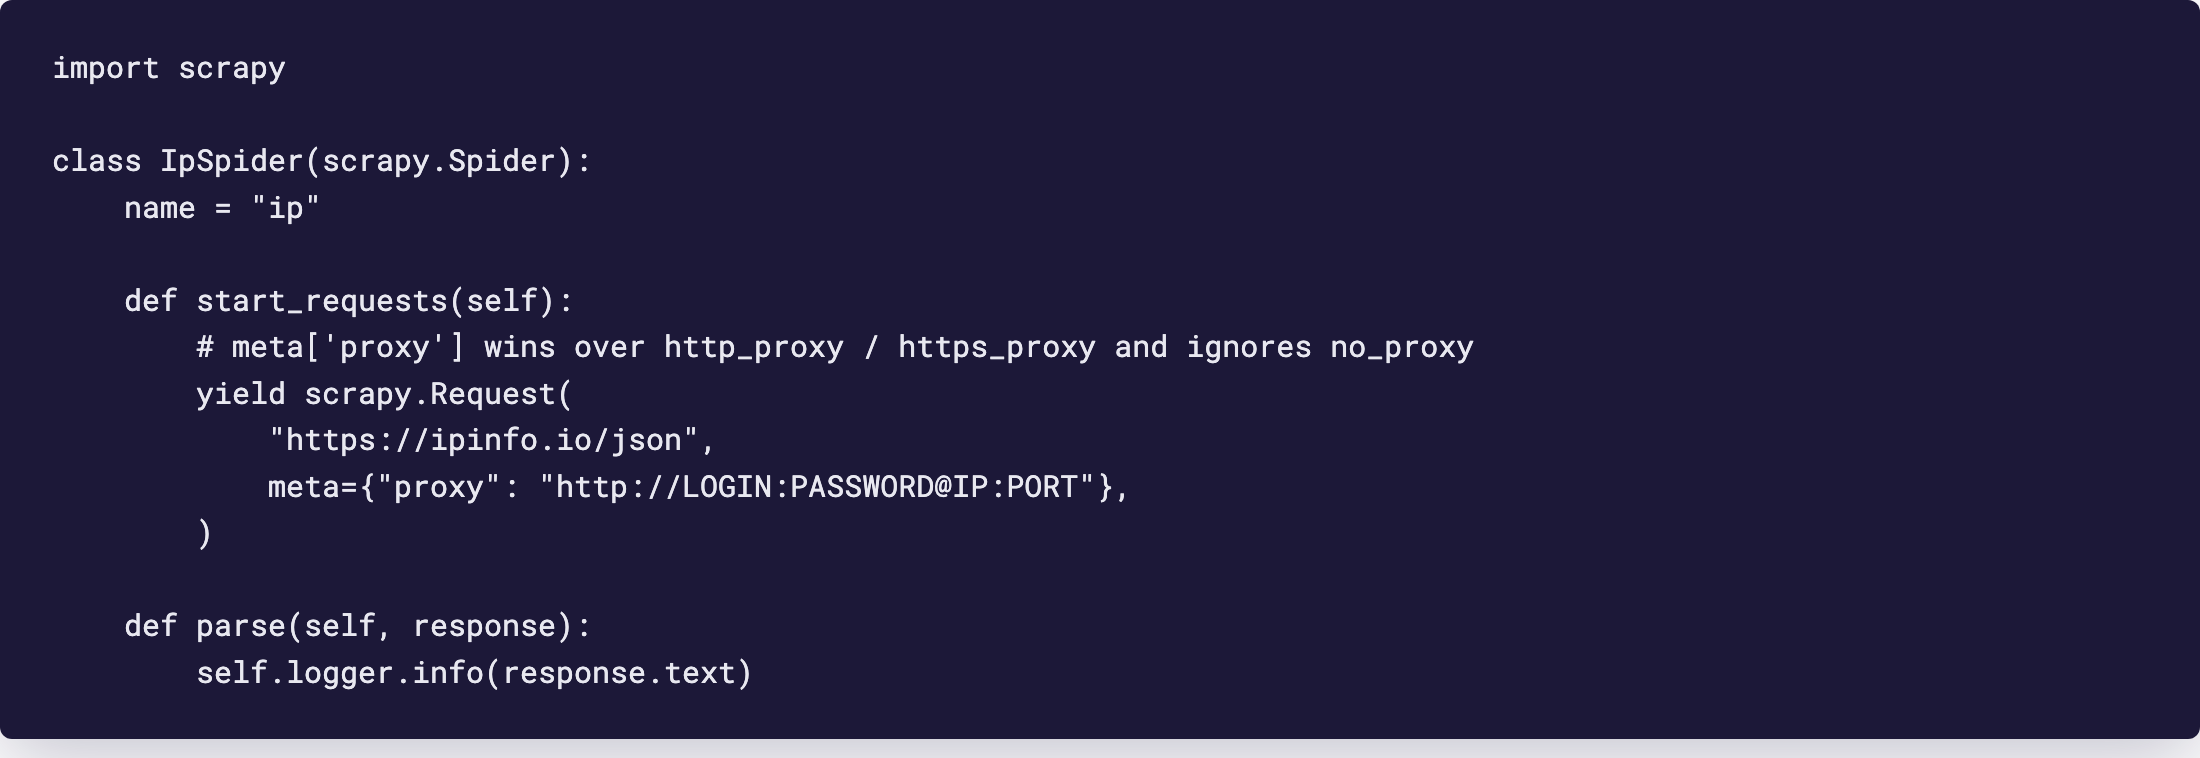
Поставьте запросу meta-ключ proxy со значением http://IP:PORT или http://LOGIN:PASSWORD@IP:PORT. Документация добавляет два предупреждения. Это значение важнее http_proxy и https_proxy, и оно полностью игнорирует no_proxy. Паук, который проверяет свой выходной IP, выглядит так.
import scrapy

class IpSpider(scrapy.Spider):
    name = "ip"

    def start_requests(self):
        yield scrapy.Request(
            "https://ipinfo.io/json",
            meta={"proxy": "http://LOGIN:PASSWORD@IP:PORT"},
        )

    def parse(self, response):
        self.logger.info(response.text)
meta={"proxy": None} делает обратное: выключает прокси для этого одного запроса, даже если переменные окружения заданы.
Один прокси на все запросы, из кода
Официального сниппета для этого в Scrapy нет. Код ниже выведен из двух задокументированных фактов: meta-ключа proxy и порядка 750 у встроенной middleware. Всё, что отработает раньше и заполнит ключ, побеждает.
# middlewares.py
class GeekProxyMiddleware:
    def process_request(self, request, spider):
        request.meta.setdefault("proxy", "http://LOGIN:PASSWORD@IP:PORT")

# settings.py
DOWNLOADER_MIDDLEWARES = {
    "myproject.middlewares.GeekProxyMiddleware": 700,
}
HTTPPROXY_AUTH_ENCODING = "utf-8"
Что происходит с паролем
Документация говорит лишь, что логин и пароль можно вписать в URL. Точные правила лежат в исходнике middleware, и спотыкаются о них чаще, чем кажется. Middleware раскодирует percent-encoding в userinfo, кодирует его в HTTPPROXY_AUTH_ENCODING и пишет заголовок Proxy-Authorization: Basic. Потом вырезает логин и пароль из meta['proxy'] и запоминает, какому URL прокси принадлежит заголовок.
Отсюда три следствия. Код, который позже читает response.meta['proxy'], видит URL без логина. Повтор или редирект на тот же прокси сохраняет заголовок. Запрос на другой URL прокси без логина заголовок теряет: middleware удаляет устаревший. Поэтому при смене прокси на каждый item передавайте логин и пароль заново. Каждый раз.
Кодировка по умолчанию latin-1. Паролю с нелатинскими символами нужна строка HTTPPROXY_AUTH_ENCODING = "utf-8" в settings.py. Спецсимволы вроде @ или : внутри URL кодируются процентами, middleware раскодирует их перед сборкой заголовка.
5 SOCKS5, ротация и sticky-сессии
SOCKS5 с логином и паролем в Scrapy работает, но с оговоркой: SOCKS понимает только httpx-обработчик загрузок. Стандартный обработчик на Twisted не умеет, а обработчик HTTP/2 вообще не трогает meta-ключ proxy. Scrapy 2.17.0 (июль 2026) добавил SOCKS и HTTP/2 в HttpxDownloadHandler; 2.19.0 (сентябрь 2026) перенёс его на httpx2, ставится через pip install scrapy[httpx]. Переключение делается в DOWNLOAD_HANDLERS: ключи http и https указывают на класс обработчика. Путь к классу берите из справочника API вашей версии, между релизами он переезжал.
С этим обработчиком URL вида socks5://LOGIN:PASSWORD@IP:PORT принимается. Уважает ли Scrapy форму socks5h:// (DNS на стороне прокси), мы не проверяли. У HTTP-прокси такого вопроса нет: CONNECT несёт имя хоста. Наш совет: оставайтесь на http://, пока что-то конкретное не потянет в SOCKS.
Один ротируемый шлюз
Логин Turbo или Flex ротирует сам. Каждое новое TCP-соединение может выйти с нового адреса, в этом весь фокус. Scrapy держит соединения живыми на хост, поэтому серия запросов к одному сайту может делить один выход, пока соединение не закроется. Так и задумано. Нужен один IP на логическую сессию, скажем на аккаунт? Кладите логин Turbo с session_id или Flex с session_time в meta['proxy'] каждого запроса этого item. И помните, что CONCURRENT_REQUESTS_PER_DOMAIN считает целевой домен, а не прокси.
Список статических IP
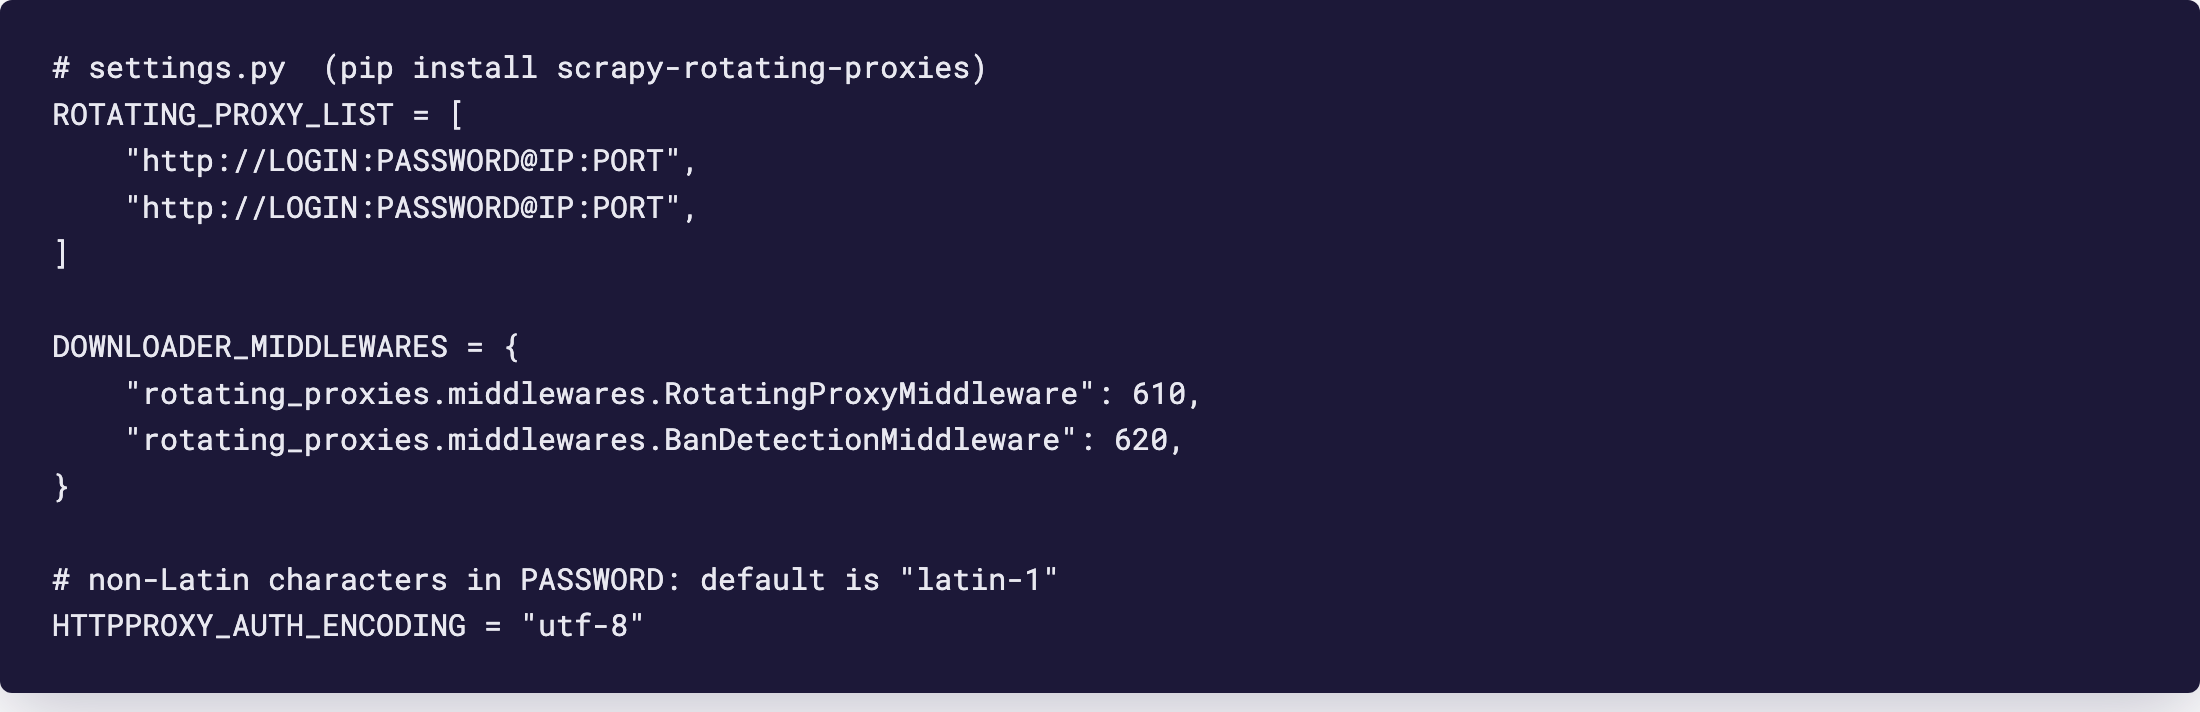
План датацентра или ISP выдаёт список, а списку нужен ротатор. Сторонний пакет scrapy-rotating-proxies читает ROTATING_PROXY_LIST или ROTATING_PROXY_LIST_PATH; если заданы оба, файл важнее. Записи могут содержать логин и пароль, в README есть формы login:password@host:port. Правило бана по умолчанию: статус не 200, пустое тело или исключение. Переопределяется через ROTATING_PROXY_BAN_POLICY либо методами паука response_is_ban и exception_is_ban.
# settings.py, pip install scrapy-rotating-proxies
ROTATING_PROXY_LIST = [
    "http://LOGIN:PASSWORD@IP:PORT",
    "http://LOGIN:PASSWORD@IP:PORT",
]

DOWNLOADER_MIDDLEWARES = {
    "rotating_proxies.middlewares.RotatingProxyMiddleware": 610,
    "rotating_proxies.middlewares.BanDetectionMiddleware": 620,
}
Пакет рассчитан на разные прокси. Только планы с оплатой за IP, не один ротируемый шлюз.
6 Проверка работы
Запустите scrapy crawl ip с пауком из раздела 4. В логе появится JSON с https://ipinfo.io/json, и поле ip должно показать адрес прокси, а не ваш. На ISP или датацентре это адрес из кабинета, на Residential или Turbo любой адрес из пула в выбранной стране.
Вторая проверка дешевле, чем звучит. Залогируйте response.meta['proxy'] внутри parse. URL прокси без логина значит, что middleware отработала и собрала заголовок. Пароль на месте значит, что middleware выключена или стоит после вашей.
7 Какой продукт GeekProxy подходит
Краулу в объёме нужна широта, поэтому Residential Turbo в ротации по HTTP или Residential Flex в ротации: он работает только по TCP, краулеру этого хватает. У Flex есть фильтр выхода -os-windows для целей, которые смотрят на TCP-отпечаток. Сайтам, которые привязывают куки к адресу, нужен sticky-логин на item, как в разделе 5. Опрос пары API дешевле на датацентре IPv4 или статическом ISP: короткий список в ROTATING_PROXY_LIST, счётчика трафика нет. Во всех случаях берите HTTP-строки. Мобильные нужны целям, которые требуют именно операторскую сеть.
8 Частые проблемы
407 Proxy Authentication Required после смены прокси на запросе
Новый meta['proxy'] указывает на другой URL без логина, и middleware сняла старый заголовок. Пишите LOGIN:PASSWORD@ в каждый URL прокси, который задаёте, включая повторы, собранные руками.
Прокси из окружения игнорируется для части запросов
У этих запросов есть meta['proxy'], а он всегда важнее. Заодно поищите meta={"proxy": None}: он выключает прокси у запроса намеренно.
Запрос к localhost уходит через прокси
meta['proxy'] игнорирует no_proxy. Поставьте локальному запросу meta={"proxy": None}.
Пароль неверный, хотя он верный
Нелатинские символы по умолчанию кодируются в latin-1. Задайте HTTPPROXY_AUTH_ENCODING = "utf-8". Пароль с @, : или # внутри URL кодируется процентами.
URL socks5:// не работает со стандартным обработчиком
SOCKS поддерживает только httpx-обработчик. Поставьте scrapy[httpx] и переключите DOWNLOAD_HANDLERS либо возьмите HTTP-порт того же плана.
Прокси для Scrapy
Ротируемые резидентские по гигабайтам или статические ISP и датацентр без счётчика трафика, выдача за секунды.
Заказать